문제: 문법상 옳은 SQL이 다른 질문에 답한다
실행 오류 없이 돌아가는 쿼리도 사용자가 묻지 않은 것을 셀 수 있습니다. '주문 건수'가 어느 테이블의 어느 컬럼인지, 어떤 기간과 범위인지, 집계어 '총계'가 단위인지 아닌지는 모델이 추측할 문제가 아닙니다. 그래서 이 엔진은 정확도를 프롬프트가 아니라 선언에서 찾습니다.
의미 계층: 용어를 계약에 묶는다
도메인 팩은 업무 용어·동의어를 선언된 지표와 차원, 실제 컬럼에 연결합니다. Semantic Resolver는 선택된 데이터 범위 안에서만 용어를 해석하고, 값의 다의성은 게이트에서 멈춥니다. 2026년 7월 9일부터 팩이 지시하는 표준 테이블명은 고객의 실제 테이블로 치환되고, 7월 19일부터 팩의 지표 정의는 서버가 SQL 구문 트리에 직접 주입합니다. 모델에게 '이렇게 써 달라'고 부탁하던 것을 컴파일러가 계약으로 강제한 전환점이었습니다.
검증 계층: 구문 트리에서 거부한다
생성된 SQL은 sqlglot으로 파싱되어 구문 트리로 검사됩니다. 허용은 단일 SELECT뿐입니다. Insert·Update·Delete·Merge·Create·Drop·Alter·TruncateTable·Command·Copy 노드, 다중 문장, 미해결 Placeholder/Parameter, 허용 목록 밖의 익명 함수는 실행 전에 거부됩니다. 구문 검사는 의미 검사를 보완할 뿐 질문에 맞는 답인지를 보증하지 않는다는 점도 코드 주석에 그대로 적혀 있습니다.
실행 계층: 읽기 전용, 상한, 재확인
승인 경로는 요청 소유자와 이전 검증 상태를 확인한 뒤 현재 권한을 다시 확인합니다. 조직 맥락이 바뀌었거나 권한이 회수되면 준비된 쿼리도 멈춥니다. 수집기는 읽기 전용 계정으로 접속해 세션 statement_timeout을 걸고, EXPLAIN으로 추정한 비용·행 수가 상한을 넘으면 실행하지 않습니다. EXPLAIN을 지원하지 않는 어댑터는 timeout과 LIMIT로 보호합니다. 어댑터는 PostgreSQL, MariaDB/MySQL, SQL Server, Oracle(11g 포함), SAP HANA 다섯 계열입니다.
근거 계층: 숫자를 결과에 묶는다
답변의 수치는 결과 값·단위와 대조됩니다(numeric grounding). 감사 기록은 질문·쿼리·승인·실행 맥락과 단계별 시간(생성, 모델 시도 횟수, 대기, 조합)을 보존합니다. 2026년 8월 17일부터 계측된 이 시간들이 현장 튜닝의 기준이 됐습니다.
현장에서 배운 것
7월 23일, 프롬프트 예시를 늘리는 실험은 라이브 검증 5건에서 개선 0으로 끝나 종결 기록과 함께 닫혔습니다. 9월 12일, 건수 질문에 합계 지표가 붙어 옳은 COUNT SQL이 막히던 결함은 '건수 의도 게이트'로, 9월 16일 '총계·합계는 단위도 업무어도 아니다'는 규칙으로 고쳤습니다. 9월 3일에는 컬럼 설명 6,460행의 한국어 업무어가 영문 약어로 치환돼 있던 것을 발견해 작업을 멈추고 대표에게 회부했습니다. 정확도는 모델이 아니라 의미 정의와 데이터 품질에서 왔습니다.
이 엔진으로 연 서비스: QueryMind
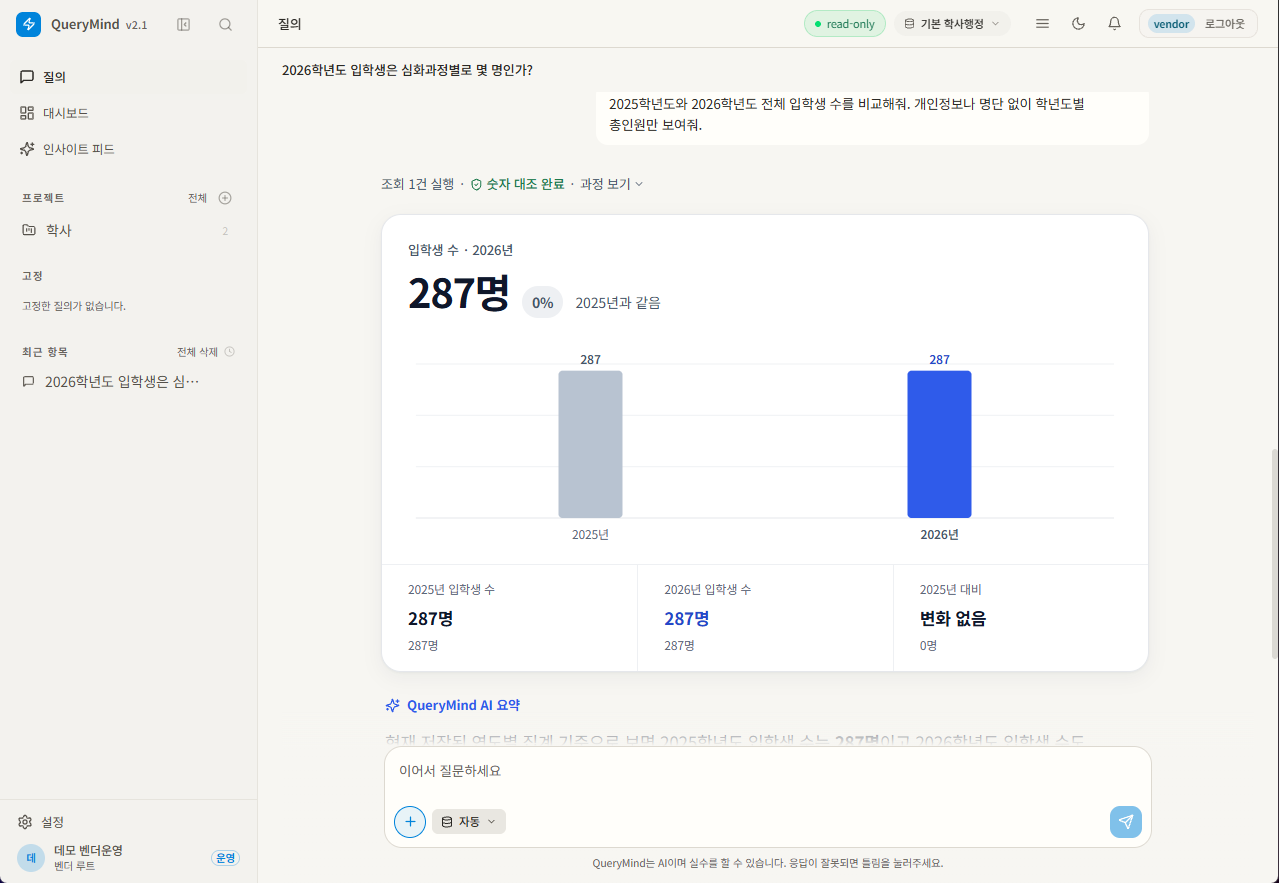
2026년 7월 28일 첫 고객 PoC, 8월 12일 첫 현장 배포, 8월 31일 Oracle 기반 대학 학사 DB 연결, 11월 7일 실고객 DB 첫 freeze 보고. 제조 ERP와 대학 학사라는 다른 세계에서 같은 엔진이 돌고 있고, 승인된 조회 정의는 MCP 도구로 발행되어 Claude·ChatGPT에서 호출됩니다. 저장소는 6월 3일 이후 3,483개의 커밋을 쌓았습니다.